ZSvirt: arquitetura da engine — async, stateless, workflow e plugins
Demorei um pouco pra trazer o segundo artigo da série. O trabalho tá uma alucaração no datacenter — estudos, LAB pra alguns projetos secundários, e a minha FARM 3D, que eu tô dedicando tempo de verdade pra profissionalizar. Ela já tá rendendo uma grana legal, mas profissionalizar exige presença. No meio disso tudo, ainda teve o artigo do TrueNAS que tinha que sair quentinho, com data de validade ali em cima.
Enfim. Agora sim: no primeiro artigo a gente olhou o ZSvirt de fora — snapshots instantâneos via ZFS, provisionamento automático, unified API. Dessa vez é o contrário. Vamos abrir a engine. Porque como foi construído explica por que funciona do jeito que funciona.
E é engenharia séria: a ZSphere, a plataforma comercial da ZStack, roda em produção em mais de 1.000 ambientes globais. O ZSvirt é essa engine herdeira, e a herança aparece em cinco pilares que você reconhece em cada commit do repositório público.
1. Framework assíncrono: não bloqueia, não aguarda
Na primeira leitura do código, o que salta à vista é a ausência deliberada de operações síncronas de longa duração. Se você criar uma VM, migrar um disco, tirar snapshot — qualquer operação que leve mais do que alguns milissegundos — o request não fica esperando. É proposital, e isso já resolve um dos maiores atritos que eu vejo em ambiente de cliente.
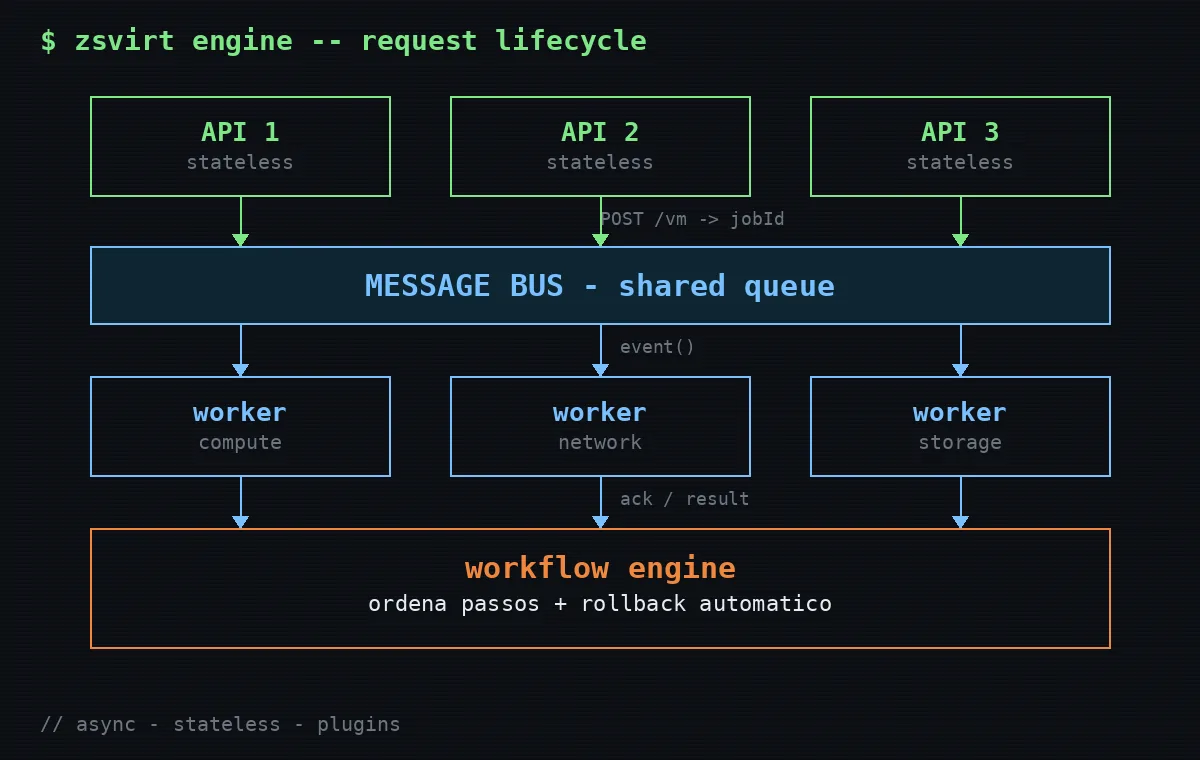
Em vez disso, o sistema usa mensagens assíncronas. Você chama um endpoint (ex: /vm), ele retorna imediatamente com um ID de job. Internamente, o request virou uma mensagem que entrou numa fila e está sendo processada por workers. No ZSvirt, você pode consultar esse job ID pra acompanhar o progresso, e quando terminar, o resultado tá lá.
# Exemplo (pseudocódigo de API):
POST /api/v1/vm
{
  "name": "web-01",
  "cpuNum": 4,
  "memory": 8589934592
}

# Retorna imediatamente:
{
  "uuid": "vm-123",
  "jobUuid": "job-456",
  "status": "Pending"
}

# Depois você pools o job:
GET /api/v1/jobs/job-456
# Retorna status em tempo real, progresso, resultado final
Por que isso importa: em um vCenter tradicional, se você lancar 100 requests de criar VM em paralelo, o servidor enfileira tudo, mas você fica bloqueado esperando responses. Com async, os 100 requests chegam, são enfileirados, e retornam em milissegundos. O processamento real acontece em background. O throughput do sistema escala sem que o cliente tenha que esperar.
Isso é especialmente crítico em ambientes de automação (Terraform, Ansible, SDKs) e em operações em massa — que é exatamente onde o Proxmox hoje sofre com timeouts e degradação. Já vi pipeline de Terraform travar meia hora porque um pvesh retornou 500 no meio da criação de 40 VMs. Com async, isso deixa de ser um problema de projeto.
2. Serviços stateless: escala horizontal sem sincronização
Cada serviço dentro da arquitetura do ZSvirt (API, workflow, compute, storage, network) é stateless. Isso significa:
- Nenhuma requisição depende de estado guardado da requisição anterior
- Nenhum serviço precisa sincronizar com outro por state compartilhado em memória
- Se um serviço falhar, outro pode pegar o trabalho do zero
Na prática: você sobe 10 instâncias da API em paralelo, coloca um load balancer na frente, e requests distribuem automaticamente. Se uma cai, as outras seguem. Não há “session stickiness”, não há quórum de sincronização, não há cache que fica desincronizado.
Isso contrasta com arquiteturas que mantêm estado em memória (Proxmox, por exemplo, onde o daemon pve-daemon é responsável por sincronizar com todos os nós). Se o daemon cai, você perde visibilidade. Já perdi uma tarde inteira debugando cluster Proxmox com o daemon fora de sincronia — log mostra uma coisa, a UI mostra outra, e o verdadeiro estado só sai lá do corosync. Em ZSvirt, a visibilidade vem de um banco de dados central (parte do management node): tudo que aconteceu está registrado, e qualquer serviço pode ler e continuar de onde parou.
3. Workflow engine: orquestração com rollback automático
Quando você cria uma VM no ZSvirt, internamente isso não é um comando isolado. É um workflow — uma sequência de passos com dependências, validações e rollback automático.
Pensa naquela montagem de móvel da loja sueca. Se na etapa 4 o parafuso não entra, você não deixa os três degraus anteriores pela metade na sala — você desmonta e volta pro ponto seguro. É literalmente esse o contrato do workflow engine: tudo, ou nada.
Exemplo (simplificado):
- Validar parâmetros da VM
- Reservar recursos no host (CPU, memória)
- Criar volume primário no storage
- Criar interface de rede
- Gerar configuração de boot
- Iniciar VM
Se qualquer passo falha, o sistema automaticamente reverte os passos anteriores. Se falha no passo 4 (rede), ele:
- Desfaz a criação da rede (passo 4)
- Desfaz a criação do volume (passo 3)
- Libera os recursos reservados (passo 2)
- Retorna erro ao usuário
Tudo isso sem intervenção manual. Sem disco órfão, sem configuração pendurada, sem recurso reservado que você esqueceu de liberar.
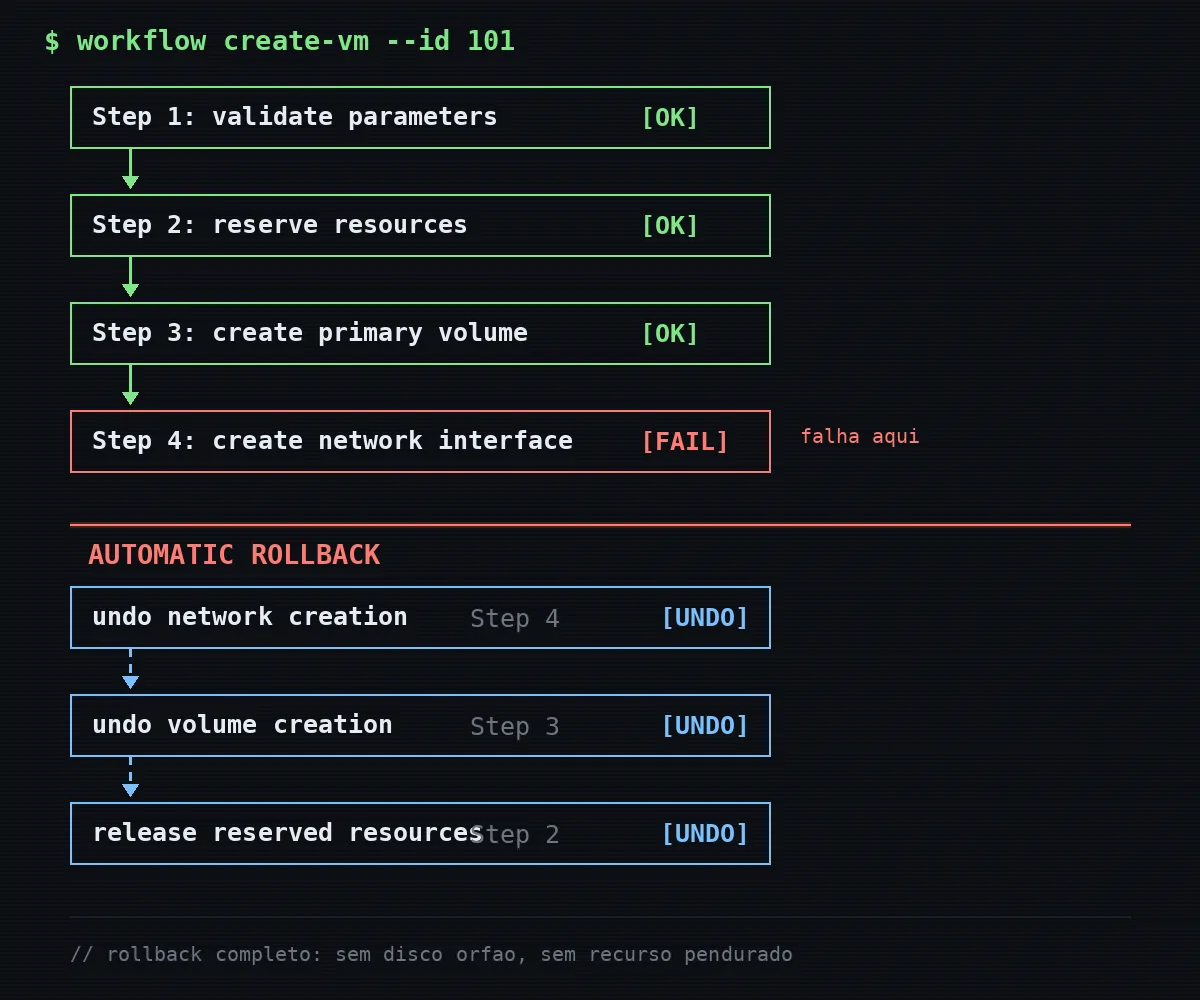
Isso é especialmente crítico em operações complexas como migração de VM, resize de disco, ou atualização de configuração em produção. Você não quer falha parcial — quer tudo ou nada.
4. Message bus: desacoplamento de componentes
Internamente, os serviços não chamam um ao outro direto (não há RPC ou REST entre workers). Em vez disso, tudo passa por um message bus centralizado.
Workflow manager publica uma mensagem “create volume”: Event(type: VolumeCreate, targetId: vol-123, params: {...}). Qualquer worker de storage que esteja escutando pega a mensagem, processa, e publica Event(type: VolumeCreated, success: true) de volta.
Benefícios:
- Desacoplamento: storage não precisa conhecer compute, compute não precisa conhecer network
- Escalabilidade: você sobe novos workers de storage sem alterar o sistema
- Resilência: se um worker de storage cai, a mensagem fica na fila e outro worker pega
- Rastreabilidade: cada mensagem é auditada, você vê tudo que aconteceu
Isso é bem diferente de arquiteturas que usam chamadas diretas. No Proxmox, se o daemon de uma node cai, o orchestrador não sabe coordenar com as outras. Em ZSvirt, o message bus é independente dos workers — se um worker cai, outros assumem.
5. Plugin architecture: extensibilidade horizontal
O último pilar é que quase tudo é um plugin. Storage backend? Plugin. Network service? Plugin. Compute hypervisor? Plugin (KVM é o padrão, mas a arquitetura suporta outros).
Novos tipos de recurso, novas capabilities, novas integrações — tudo entra como um plugin que se registra no sistema e expõe seus endpoints via API.
Isso explica como o TrueNAS consegue ser um storage backend nativo — é um plugin que implementa a interface de storage e se integra ao workflow engine. Não precisa de fork do código, não precisa de merge upstream, não precisa recompilar. É puro plugin.
Como essas cinco coisas trabalham juntas
Imagine uma operação complexa: você quer migrar uma VM entre dois hosts e tirar snapshot ao mesmo tempo (pra ter um backup imediato pré-migração).
- Async: você faz um POST
/vm/migrate+/vm/snapshotem paralelo. Ambos retornam imediatamente com job IDs. - Stateless: essas requisições podem chegar em APIs diferentes (você tem 3 instâncias rodando).
- Workflow: internamente, cada operação é orquestrada como workflow — migrate tem 8 passos, snapshot tem 4. Se algum falha, rollback automático.
- Message bus: migrate publica “VM migration started” no bus. Snapshot worker escuta, pode fazer backup pré-migração. Se network worker vê que o host está ocupado, publica um evento que o workflow engine respeita.
- Plugins: o snapshot worker é um plugin de storage. A migração usa um plugin de compute. Nenhum dos dois conhece um ao outro — só conversam via message bus.
Resultado: operação complexa, auditável, resiliente, escalável — tudo sem lock global, sem ponto de falha único, sem estado compartilhado em memória.
O que você não vê (mas importa pra engenharia)
Tem alguns detalhes do código que valem mencionar:
Idempotência: cada operação é idempotente por padrão. Se você enviar o mesmo request duas vezes, a segunda fica esperando a primeira terminar e retorna o mesmo resultado. Nunca duas VMs com o mesmo ID, nunca dois discos com UUID duplicado.
Eventual consistency: o sistema favorece disponibilidade sobre consistência imediata. Depois de uma operação, pode levar alguns segundos pra todos os nós verem o estado atualizado — mas eventualmente convergem. Isso é aceitável pra maioria dos workloads de VM.
Circuit breaker patterns: se um serviço começa a falhar (ex: storage respondendo lento), o message bus para de enviar requisições pra ele, logs alertam, e você pode intervir. Sem cascata de falhas.
Na minha leitura
Essa arquitetura que você vê no ZSvirt não é nova em conceito — é aplicação inteligente de princípios que você vê em sistemas distribuídos maduros (Kafka, Cassandra, Kubernetes). A diferença é que é dirigida para o problema específico de virtualização — onde você precisa de confiabilidade, escalabilidade e auditabilidade.
Comparar com o Proxmox aqui é inevitável — e antes que qualquer especialista em PVE levante a mão, deixo claro: o Proxmox foi desenhado pra ser enxuto, direto e simples de operar, e nisso ele entrega muito bem. O ZSvirt partiu de outra premissa de projeto: management plane dedicado, isolado do compute, com o histórico da ZSphere rodando em mais de 1.000 ambientes enterprise. São filosofias diferentes para públicos diferentes, não um “certo e errado”.
Mas não confunda escala com simplicidade. ZSvirt é mais complexo de debugar quando algo dá errado, porque o estado está distribuído e precisa ser reconstruído a partir de eventos. Proxmox você vê tudo num daemon. O trade-off é claro: mais escalabilidade, mais complexidade operacional.
Sendo honesto sobre o limite dessa análise: eu ainda não instalei a engine em escala — meu ambiente é o live demo e o repositório público. Isso aqui é leitura de engenharia, não relatório de produção. O lab de verdade, com instalação e primeira VM, é o artigo que vem na série. Quem opera cluster grande me avise nos comentários — quero validar essa leitura contra a prática de quem roda 50+ hosts.
Na sequência da série: o comparativo técnico honesto com Proxmox e Nutanix — onde cada um ganha, onde cada um perde, e onde encaixa na sua infraestrutura real.
Fontes usadas neste artigo: Repositório ZSvirt no GitHub · README — Architecture · Roadmap 2026H2 · Glossário oficial · Docs ZSvirt